発表発表日 最終確認
翌日の点では、Grok 4.7 は負けた
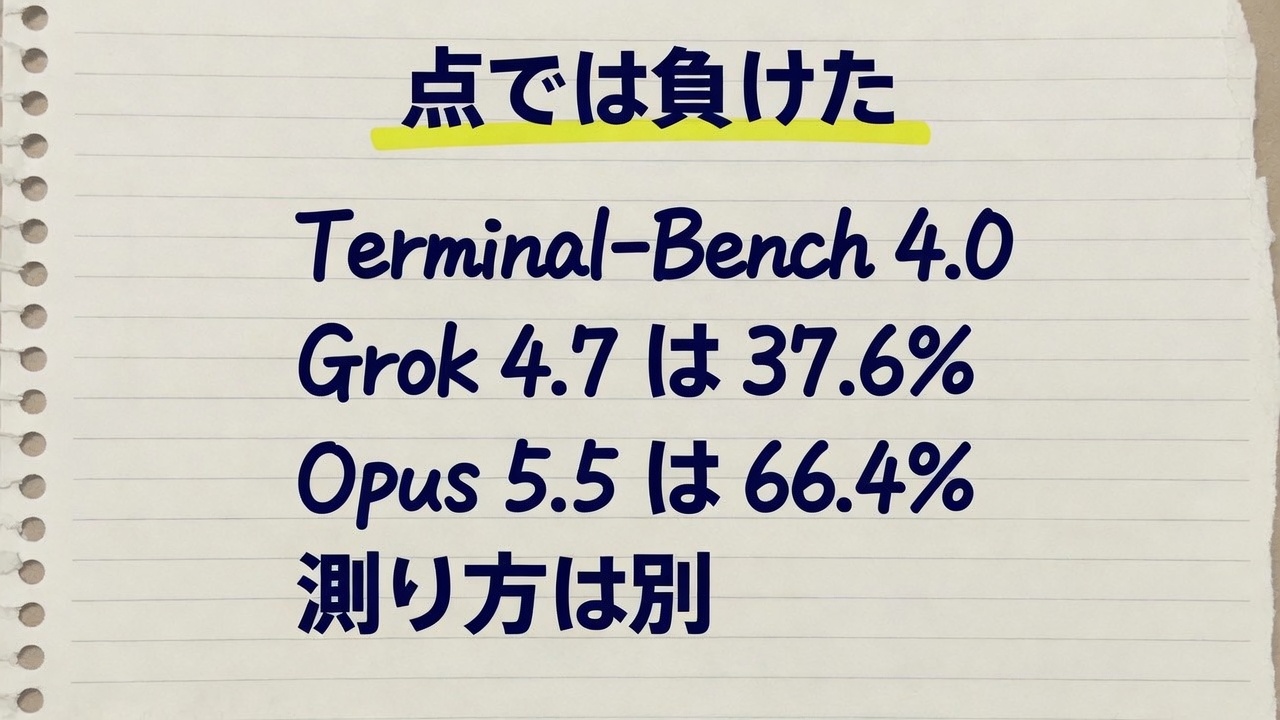
2026-09-22 に Claude Opus 5.5 と GPT-6 Sol、GPT-6 Luna が出ました。Terminal-Bench 4.0 は、前日の Grok 4.7 が 37.6% で、Opus 5.5 は 66.4% です。測り方は別です。API の単価は、Grok の方がまだ安いです。
このページは に確かめたものです。そのあとで変わっているかもしれません。
翌日に、もっと高い点が並んだ
2026-09-21 に Grok 4.7 が出ました。その翌日の 2026-09-22 に、Claude Opus 5.5 と GPT-6 Sol、GPT-6 Luna が出ました。前日のメモは Grok 4.7 は一番ではない です。前日の時点で、第三者の総合点はすでに Fable 5.1、GPT-6 Astra、Opus 5 の下でした。翌日に出た表で、その差はさらに広がりました。
いちばん上の図は Terminal-Bench 4.0 です。xAI が 9 月 21 日に出した Grok 4.7 は 37.6% で、Anthropic が 9 月 22 日に出した Opus 5.5 は 66.4% です。同じ名前のテストですが、動かし方は同じではありません。Anthropic の注によると、Opus 5.5 の点は、考える量を多めにする xhigh という設定で測ったものです。GPT-6 Astra の 57.9% は、OpenAI が high の設定で出した点です。Grok の 37.6% は、xAI 自身の表にある点です。ですから、一つのレースの順位表として読むことはできません。それでも、点の開きは大きいです。負けています。
どこで会うか
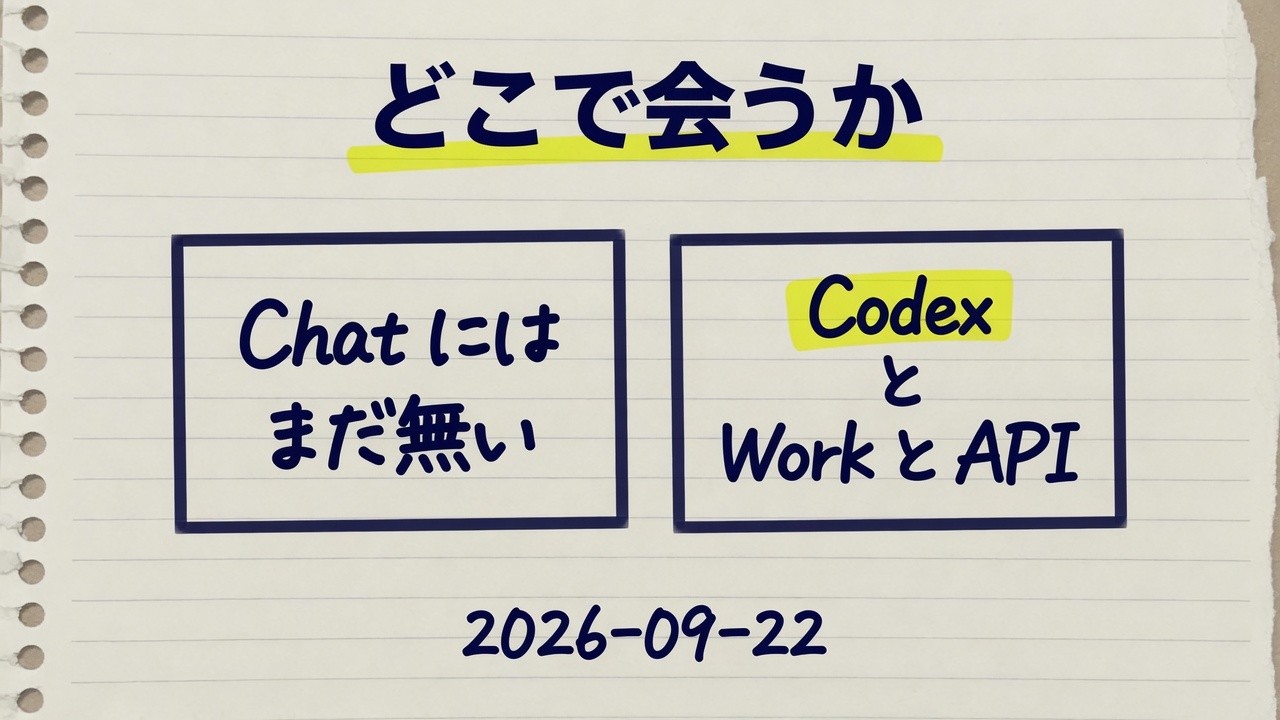
GPT-6 Sol と Luna は、OpenAI の発表では ChatGPT Work、Codex、API の三つで使えます。対象のプランは Plus、Pro、Business、Enterprise、Edu です。Free と Go の人は、デスクトップアプリで Luna を試せます。Chat にはまだ無い、と発表には書いてあります。API での名前は gpt-6-sol と gpt-6-luna です。いちばん賢いモデルは引き続き Astra だ、と OpenAI は書いています。Sol と Luna は、その賢さを安く使えるようにしたモデルです。
Opus 5.5 は、Anthropic が同じ日に出した Claude 5.5 の最初のモデルです。ふだんの仕事では Fable 5.1 と同じくらいの出来で、動かす費用は Opus 5 より 40% 安い、と書いてあります。出力の速さも Opus 5 より 30% 以上速い、とあります。
単価は、まだこっちが安い
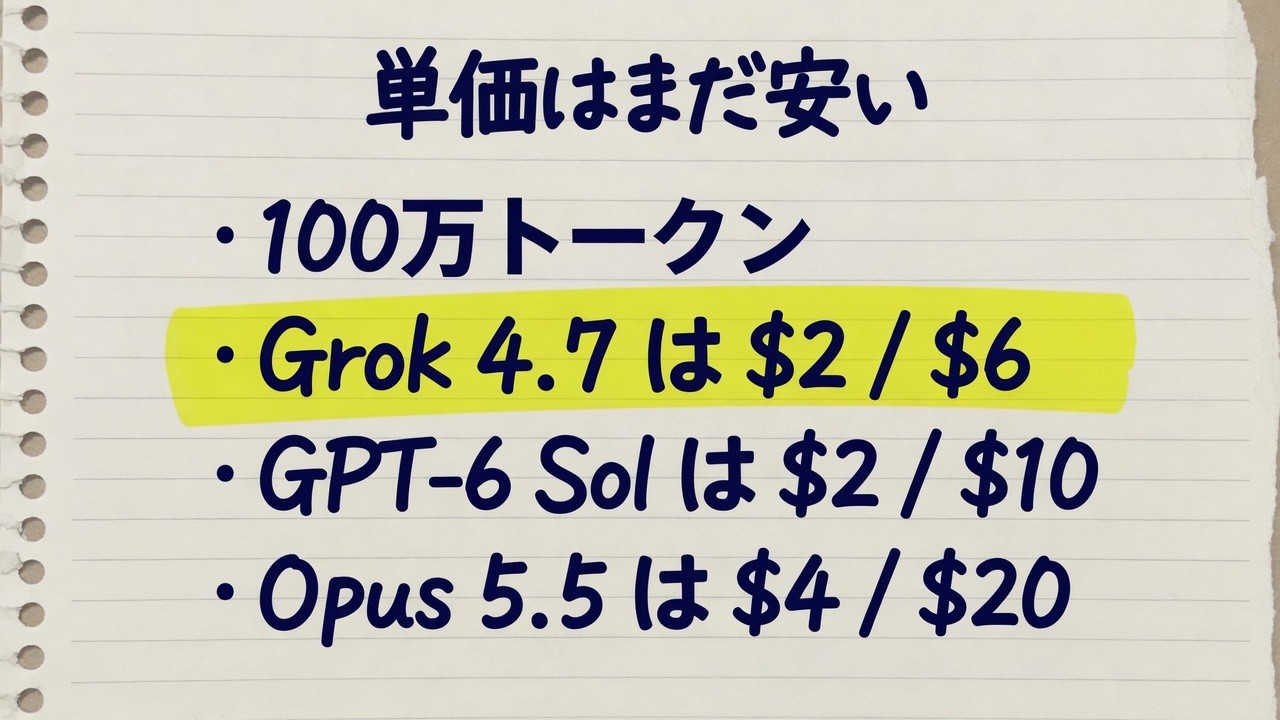
Grok 4.7 は、入力 $2、出力 $6 です。GPT-6 Sol は入力 $2、出力 $10 です。Opus 5.5 は入力 $4、出力 $20 です。Luna は入力 $0.10、出力 $0.50 で、この中ではいちばん安いです。Sol と Luna の単価は、GPT-5.6 のプロモーション価格から 50% 下げたものだ、と OpenAI は書いています。Opus 5.5 で、キャッシュから読む入力は $0.20 です。速いモードは入力 $8、出力 $40 です。
点で上にいるのは Opus 5.5 で、単価は Grok より高いです。Sol は、入力は Grok と同じで、出力は Grok より高いです。ですから、安いから Grok に残る、という言い方はまだできます。ただ、点で選ぶなら、この日の表で選ぶ先は Grok ではありません。それに、1 件で払う額は単価だけでは決まりません。長く書かせるほど、払う額は増えます。その話は前日のメモに書きました。
ほかのテストでも、Grok は一番ではない
CursorBench 4.0 は、Anthropic の表では Opus 5.5 が 57.8%、Fable 5.1 が 51.8%、Opus 5 が 46.6%、GPT-5.6 Sol が 41.7% です。Astra のマスは空欄です。xAI が前日に出した Grok 4.7 は 46.3% です。並べると、Opus 5.5 と Fable 5.1 の下で、Opus 5 とほぼ同じで、GPT-5.6 Sol よりは上です。
DeepSWE は、考える量の設定が各社でそろっていません。xAI の表では、Grok 4.7 は high の設定で 71.0% です。OpenAI の発表では、GPT-6 Sol は max の設定で 68.8% で、Fable 5 が xhigh で出した 69.9% に近い、とあります。設定がそろっていないので、このテストだけは勝ち負けを言いません。
Anthropic の表に、Grok の列はありません。Astra と Opus 5.5 の点は、下の図にあります。
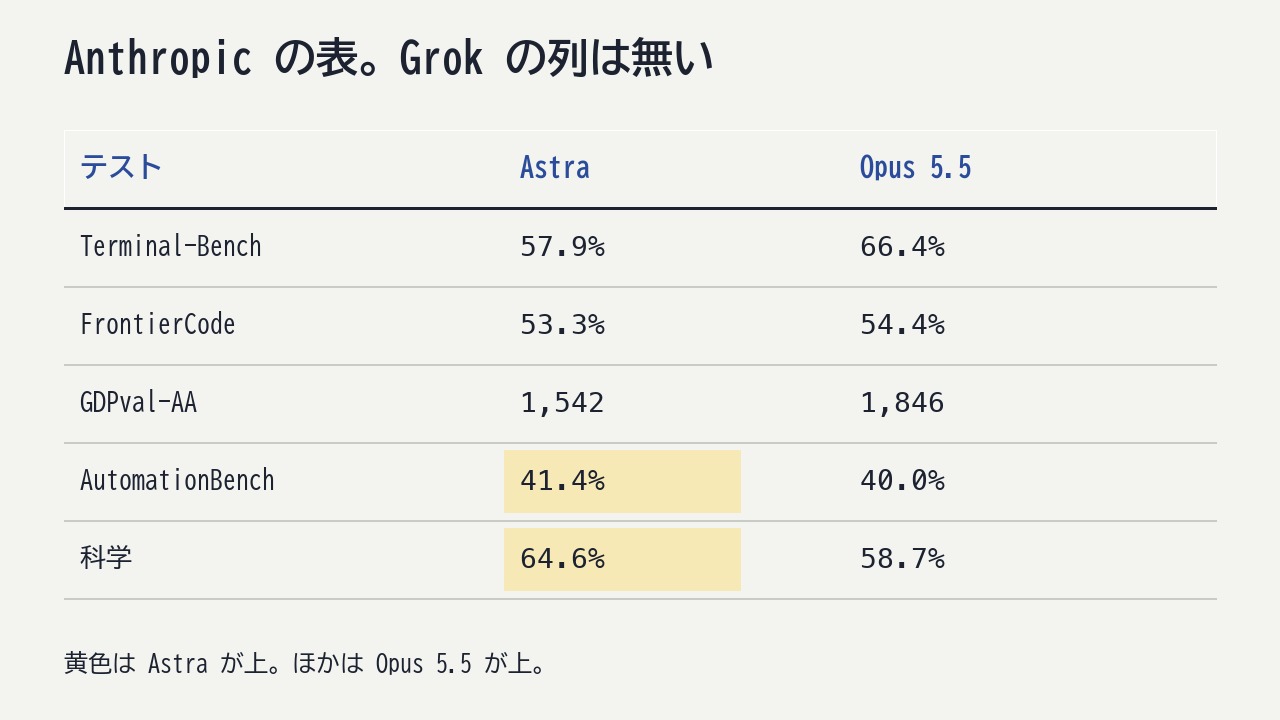
安全装置が働いた問題について、Anthropic は注でこう書いています。サイバーの問題は Opus 4.8 に、生物とフロンティアの開発の問題は Opus 5 に回した、と。その分、Opus 5.5 の点は下がりやすい、ともあります。そうして下がった後の 66.4% でも、Grok の 37.6% より上です。
ファンとして、残る理由と、残らない理由
単価を見れば、残る理由はあります。点を見れば、一番だとは言えません。前日の第三者の総合点は 46 で、Fable 5.1 と Astra の 53、Opus 5 の 51 の下でした。翌日に出た公式の表では、一番なのは Opus 5.5 です。
長いコードを Grok Build に書かせる使い方なら、前日のメモに書いたとおり、4.7 はまだ十分に使えます。点で一番のモデルが要る仕事なら、この日の発表を見てください。どこにいくら払うかは、やりたいことで払う場所が決まるに書きました。
次を待つ理由は、計算機です。Colossus のページには、xAI が 122 日で建て、92 日で GPU 20 万台まで倍にした、とあります。2026-01-06 の資金調達の発表は別の数え方で、2025 年末に Colossus I と II を合わせ、H100 の性能に換算して 100 万枚分を超えていた、と書いています。xAI は Colossus のページで、この規模と速さで建てた会社はほかにない、と言い切っています。2026-05-06 には、Colossus 1 を Anthropic にも使わせると発表しています。持っている全部が、次の Grok の学習に向くわけではありません。それでも xAI は、自分で建てて、短期間で増やした会社です。この日の点は負けです。ファンとしては、計算機を増やす速さを見て、次のモデルまでの時間は短いと期待しています。
よくある取り違え
- 「同じ日の同じ表で 38% 対 66%」と読む: 37.6% は xAI が 9 月 21 日に出した表の点で、66.4% は Anthropic が 9 月 22 日に出した表の点です。考える量の設定も、動かし方も違います
- 「Sol は Chat で今すぐ使える」: 発表には、Chat にはまだ無い、と書いてあります。使えるのは Codex と ChatGPT Work と API です
- 「単価が安いから勝った」: 単価はたしかにまだ安いです。ただ、Terminal-Bench と CursorBench の点は、Opus 5.5 の方が上です
- 「DeepSWE の 71% が総合一位」: 71.0% は、xAI 自身が high の設定で出した点です。翌日の Sol は max の設定で 68.8% です。同じ条件で測った点ではありません
- 「計算機が多いから、この日は勝っていた」: 計算機の量は 2025 年末の換算で、点は 9 月 22 日の表です。別の話です。翌日の点は、それでも Opus 5.5 が上です
- 「持っている計算機が、全部 Grok の学習に向いている」: 2026-05-06 に、Colossus 1 を Anthropic に使わせると発表しています。書いてある用途は Claude Pro と Claude Max の容量です
コメント
いまはコメントを受け付けていません。記事はそのまま読めます。