発表発表日 最終確認
Grok 4.7 は一番ではない。単価を据えて長く働く
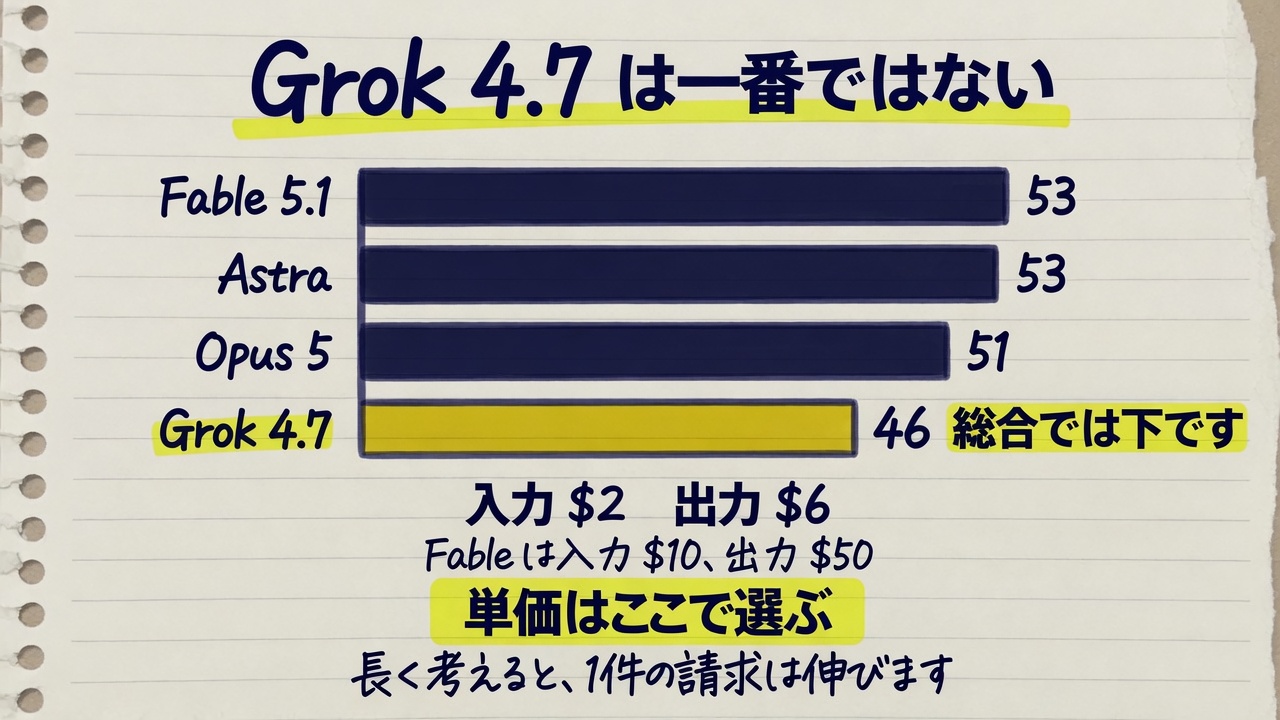
2026-09-21 に Grok 4.7 が出ました。総合点は 46 点で、Fable 5.1 と GPT-6 Astra の 53、Opus 5 の 51 より下です。API は入力 100 万トークン $2、出力 $6 で、Grok 4.6 と同じ単価です。長く考えると出力が増え、払う額は増えます。
このページは に確かめたものです。そのあとで変わっているかもしれません。
このページの内容
何が変わったか
2026-09-21、x.ai は Grok 4.7 を出しました。発表ページに書いてある名前は SpaceXAI です。コーディングと、調べて文書にまとめる仕事向けで、4.6 より大きいモデルを、前より長く、難しい問題で鍛えた、と書いてあります。何時間もかかる問題も、前より多く鍛えた、とも書いてあります。鍛える手法は強化学習です。自分の出力を見直し、長い文脈を扱い、Grok Bot の進め方が分かるように訓練した、という説明です。
見出しは「同じクラスの半分の値段で、2 倍速い」です。本文は「4.6 と同じ値段、同じ速さ」です。表の入力は 100 万トークン $2 で、GPT-5.6 Sol の $4 の半分、Fable 5.1 の $10 の 5 分の 1 です。出力は $6 で、Sol の $20、Fable の $50 より安いです。見出しの「半分」は、入力の単価を Sol と比べたときの言い方に近いです。出力の差はもっと大きいです。fast は、出力の速さが 2 倍で、単価も 2 倍、と本文にあります。
It works longer on difficult tasks, checks its own work more carefully, and comes with our best-calibrated safeguards to date. Served at the same price and speed as Grok 4.6.
2026-09-21 の発表です。x.ai/news/grok-4-7
安全の点数も、同じ発表の自己申告です。断る力と、抜け道への耐性は、自分たちが測った中で一番強い、と書いてあります。LatchBio の、生物まわりの危ない依頼を断るテストでは 62.4% で首位、と書いてあります。HackerBench v0.3 では、危ない依頼の 3.3% だけが通り、ふつうのセキュリティの仕事はあまり止めない、と書いてあります。防御側の研究のために、選んだ相手へ招待制で検証用の機能を渡し始めた、とも書いてあります。この点数は断るテストの点です。診断や、生物の実験の判断には使いません。
どこで使えるか
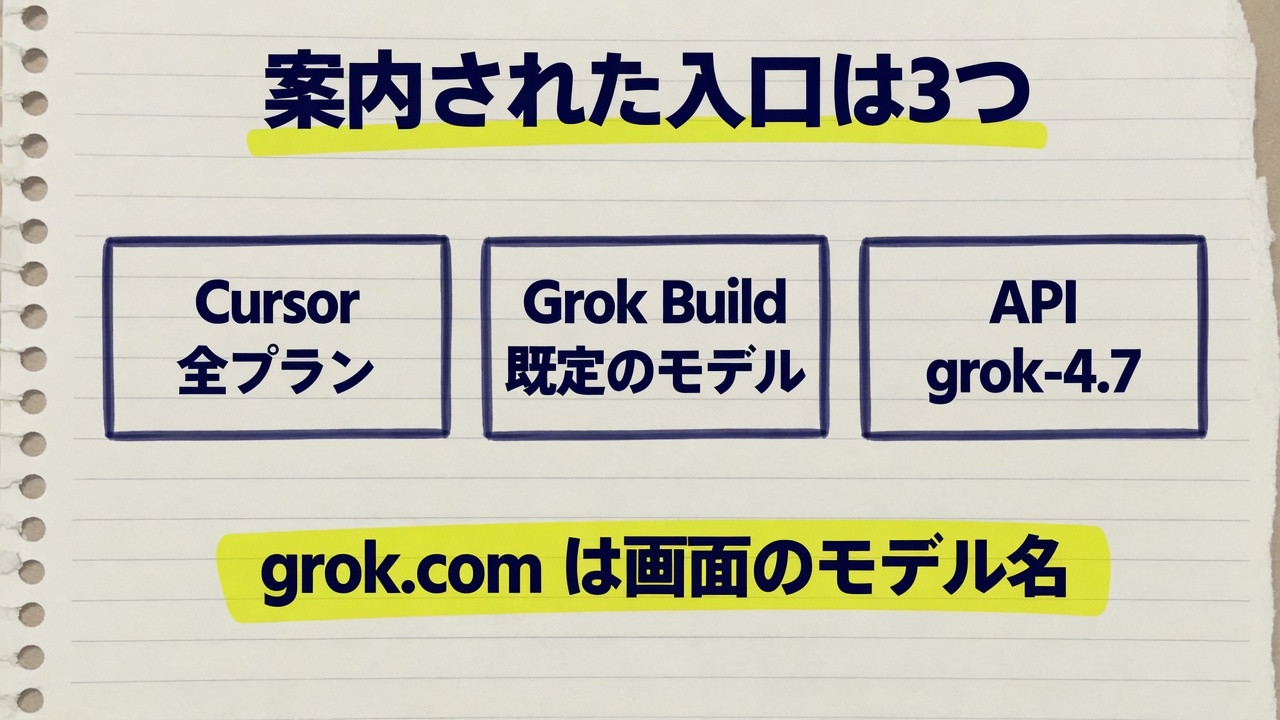
2026-09-21 の発表と docs が案内した入口です。
| 入口 | 案内 |
|---|---|
| Cursor | 全プランで使えます。fast は単価が 2 倍です |
| Grok Build | 既定のモデルです。無料で試せる枠に fast は入りません |
| API | モデル名は grok-4.7 です。fast は公開 API では配っていません |
| ルーター | OpenRouter、Vercel、Cloudflare の名前が docs にあります |
案内に名前があるのは、Cursor、Grok Build、API、それにルーターです。grok.com は、開いている画面のモデル名を見てください。Imagine と Voice は別のモデルです。動画を作れる本数は、Imagine の決まりのままです。
チャット、Grok Bot、Grok Build は 別の道具 です。入口が分かれている話は grok.com、公式アプリ、X の 3 か所 です。Grok Build に仕事を渡すときの切り方は 重い仕事は Grok Build に渡す に書いています。
API の料金
2026-09-21 のリリースノートによると、プロンプトが 20 万トークンを超えると単価が倍になります。単位は 100 万トークンあたりの USD です。円は書きません。
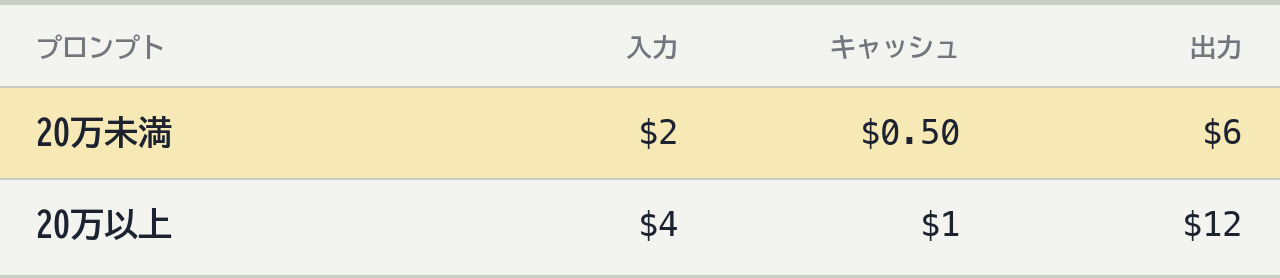
キャッシュは、同じ入力を再利用したときの入力単価です。考えているあいだのトークンも、使った分に入ります。努力は low、medium、high、xhigh から選べて、既定は high です。Artificial Analysis が総合点に使ったのは xhigh です。
fast は同じモデルを速い機材で配るもので、トークン単価は 2 倍です。配っているのは Cursor と Grok Build です。公開 API は通常の単価です。Grok Build の無料で試せる枠も、通常のモデルです。
モデル名は grok-4.7 です。文脈は 50 万トークンで、4.6 と同じです。知識の区切りは 2026 年 5 月です。入力はテキストと画像、出力はテキストです。docs はテキスト出力について “No text output limit” と書いています。grok.com で使える回数とは別の話です。
月額の SuperGrok と、この API は別の支払いです。払う場所は やりたいことで決まります。API の請求は console.x.ai で見てください。
xAI が並べた点
これは出した本人の表です。第三者の点は、このあと Artificial Analysis と Vals に分けて書きます。2026-09-21 の発表の表です。列は Grok 4.7 が xHigh、Grok 4.6 が High、GPT-5.6 Sol が Max、Fable 5.1 が Max です。DeepSWE の 4.7 だけ、注記が high です。Astra と Opus 5 は次の節です。相手の単価は、xAI がこの表に置いた数字です。
列ごとの点は、発表のページで見てください。
CursorBench は長めのコーディング、DeepSWE はソフトウェアの課題、EEBench は電気回路、AA Briefcase は何時間もかかる事務、Terminal-Bench はターミナルで長く作業するテスト、Harvey は法律のエージェント、HealthBench は臨床の推論です。法律と臨床の行は、そのテストの点です。契約や診断を任せてよい、という意味ではありません。
4.6 より上がった行がほとんどです。Fable 5.1 より上なのは、DeepSWE、EEBench、Harvey です。CursorBench、AA Briefcase、Terminal-Bench、HealthBench は Fable が上です。Sol より下なのは DeepSWE と HealthBench で、ほかの行は Sol 以上です。Terminal-Bench は 4.6 の 20.3% から 37.6% まで上がり、それでも Fable の 57.9% とは離れています。
Astra と Fable と Opus
Artificial Analysis は、自分で測る第三者です。Astra と Opus 5 は、2026-09-21 の記事と、2026-09-22 の比較ページで比べます。モデル一覧の総合 1 位は Fable 5.1(max、fallback あり)の 53 です。GPT-6 Astra(max)も 53、Opus 5(max)は 51、Grok 4.7(xhigh)は 46 です。4.7 の high も総合は 46 です。xAI の表は Max と書き、Artificial Analysis は max(fallback あり)と書いています。努力の名前は別です。
Elo は勝ち抜きの点数で、大きいほど上です。GDPval-AA は、弁護士や看護師や金融の実務を模した仕事です。2026-09-22 の順位表では、Fable 5.1(max)が 1,735、Opus 5(max)が 1,708、Grok 4.7(xhigh)が 1,695、Grok 4.7(high)が 1,694、GPT-6 Astra(max)が 1,542 です。4.6(high)は 1,605 でした。
記事のいちばん上の図が、この総合です。元のチャートは、下の投稿の中にあります。コーディングでも Astra の下です。
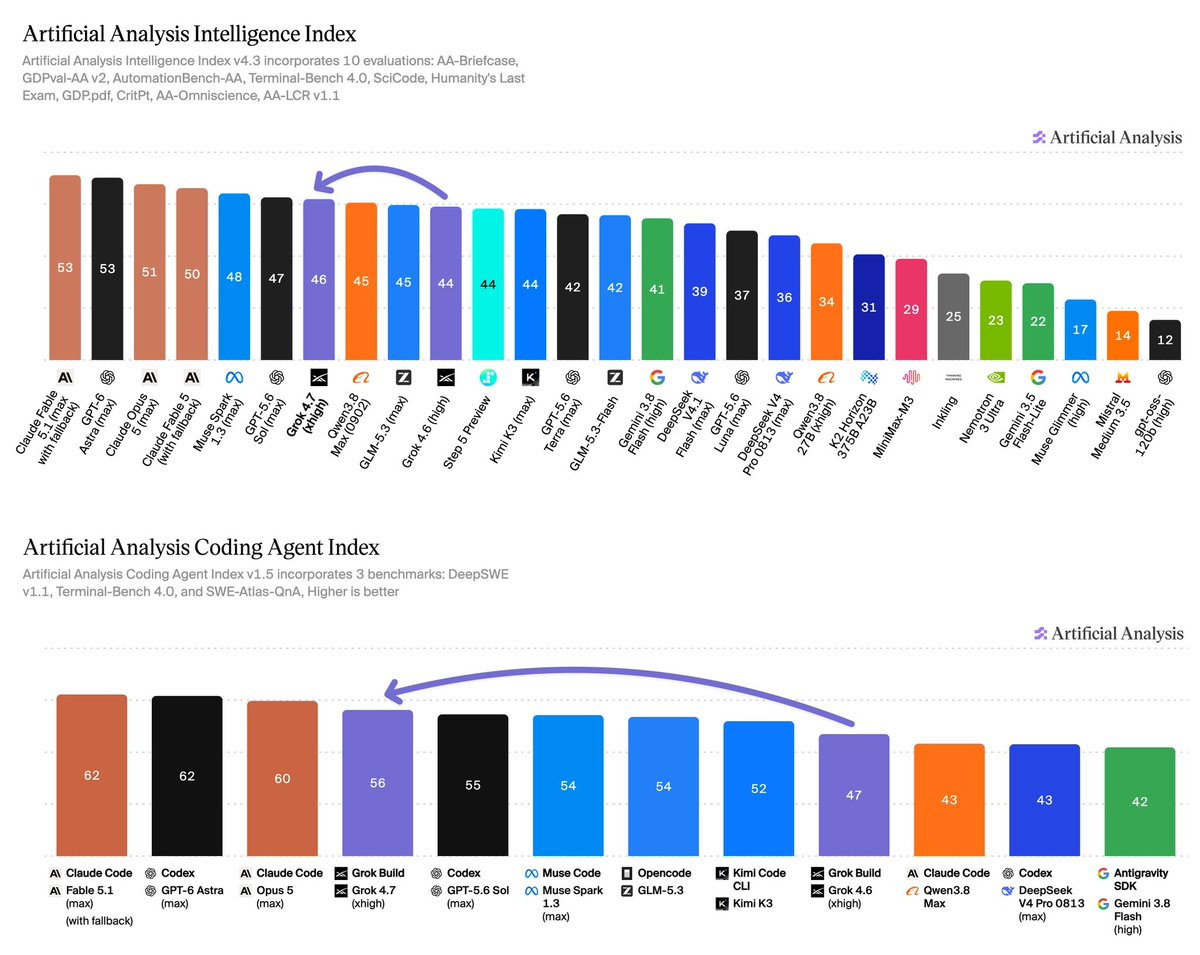
書類や表やスライドを作る GDPval では Astra の上で、Opus 5 のすぐ下です。努力を high から xhigh に上げても、総合は 46 のまま、GDPval は 1,694 と 1,695 で、ほとんど動きません。
コーディングは、Grok 4.7(xhigh)を Grok Build で動かした Coding Agent Index が 56 です。4.6(xhigh)の 47 から 9 点上がり、GPT-5.6 Sol を超えました。同じ指標で、各社が自分の開発ツールで動かした結果を並べると、4 番目です。上位は Fable 5.1、GPT-6 Astra、Opus 5 です。内訳は、DeepSWE が 65% から 73%、Terminal-Bench 4.0 が 18% から 33%、SWE-Atlas-QnA が 58% から 63% です。
xAI の表は DeepSWE 71.0%(high)、Terminal-Bench 37.6% です。同じ名前でも、努力と、動かし方が違えば点は違います。Artificial Analysis は、総合点の方の Terminal-Bench 4.0 は 4.5 点上がった、とも書いています。37.6% とは別の測り方です。
事務仕事の AA-Briefcase は 1,657 Elo で、4.6(high)から 111 上がり、Opus 5 と Fable 5.1 のすぐ後ろ、と書いてあります。棒の並びは、この投稿です。
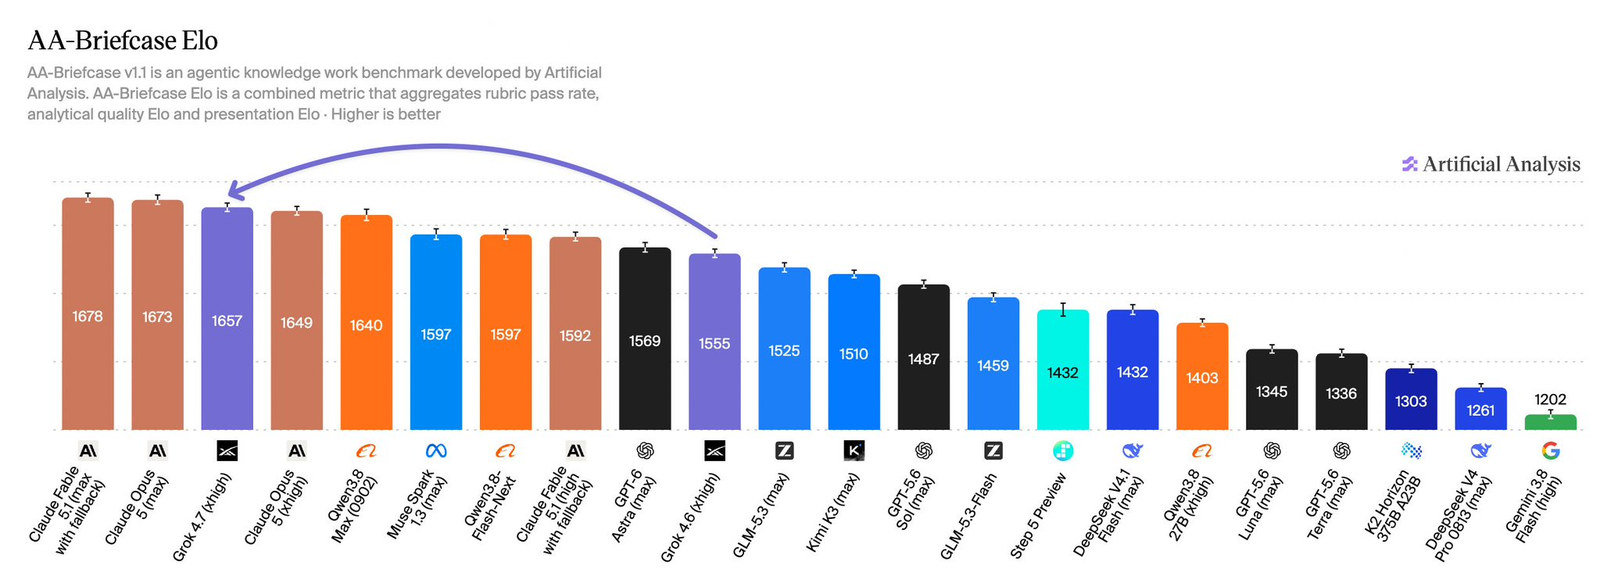
xAI の表の Fable は 1,678 で、差は 21 です。中身の Elo は 1,690 から 1,994 に上がり、見た目の Elo は 1,519 から 1,499 に下がりました。分析は良くなって、スライドの体裁は少し落ちています。
総合点のほかの科目は、4.6(high)とおおむね同じです。上がったのは Terminal-Bench 4.0 が 4.5 点、書類を読む GDP.pdf が 3.0 点です。下がったのは長い文脈の AA-LCR が 3.7 点、作業手順の AutomationBench-AA が 1.1 点です。幻覚の割合は 34% から 29% です。当たっている割合は 4.6 の 48% に対して 47% で、ほとんど変わっていません。
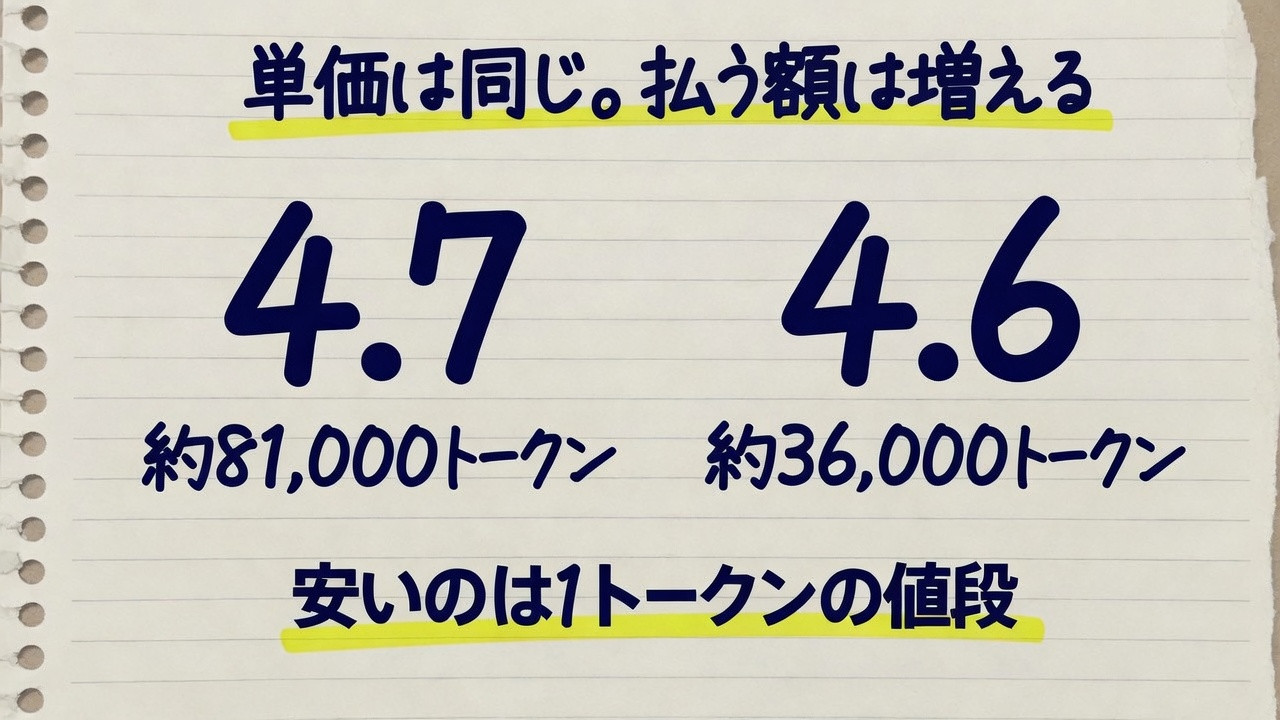
トークンは増えています。総合点の 1 問で、4.7(xhigh)の出力は約 81,000 トークンです。4.6(high)は約 36,000、4.6(xhigh)は約 38,000、Astra(max)は約 27,000 です。単価が安くても、1 問で書く量は Astra の約 3 倍です。長いプロンプトの出力速度は約 188 トークン/秒、総合点の 1 問に約 7.1 分、と書いてあります。これは fast の宣伝文句とは別の計測です。
Vals の実務テスト
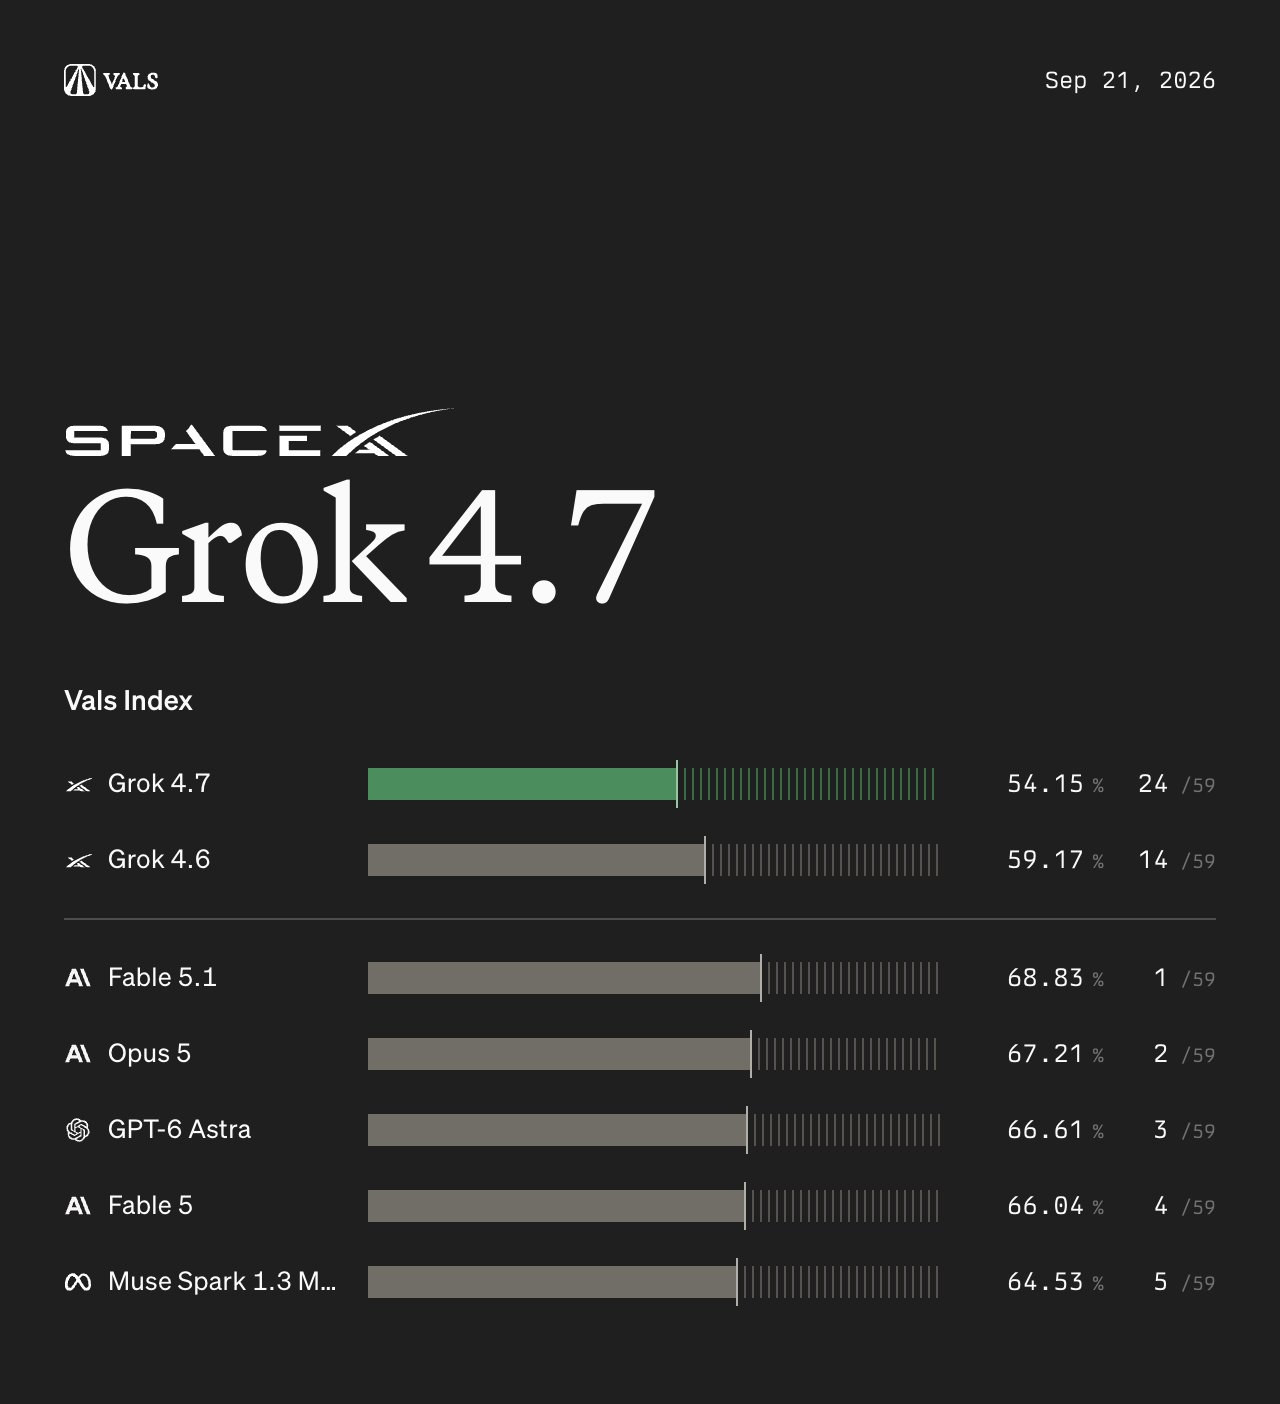
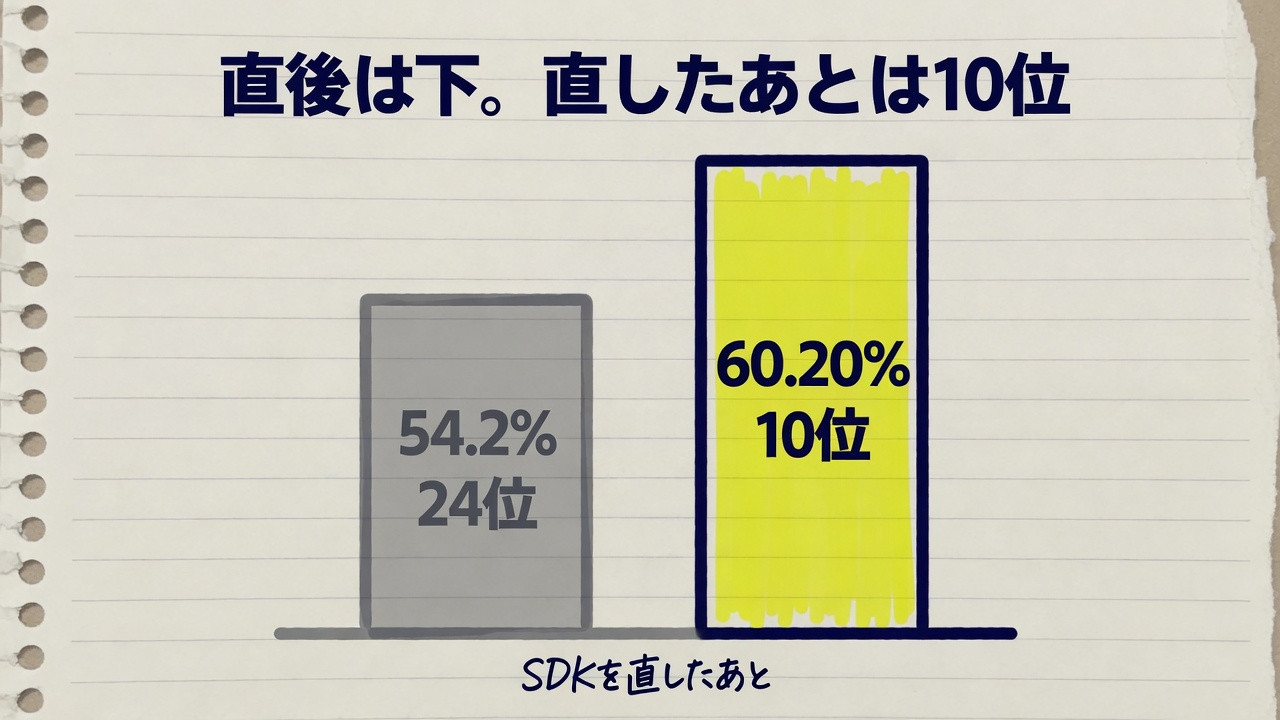
Vals も、自分で課題を回す第三者です。2026-09-22 に vals.ai を開くと、各社の一番良いモデルを並べた表で、Grok 4.7 は 60.20% です。上は Fable 5.1 の 68.83%、GPT-6 Astra の 66.61%、Muse Spark 1.3 Max の 64.53%、Gemini 3.8 Flash の 62.25% です。全モデルの Vals Index では 59 中 10 位で、誤差は ±1.08 です。1 回 $11.90、待ち時間は 32 分 54 秒、と モデルページにあります。4.6 は 59.17%、4.5 は 51.53% です。測ったのは公式 API の xhigh です。上位 3 つの 1 回は $18.81 から $28.92 で、総合の 1 回だけ見ると Grok は安いです。
出荷の直後は、別の数字でした。2026-09-21 の投稿は 54.2% で 24 位、4.6 の 59.2%(14 位)より下、4.5 の 51.5% より上、と書いています。同じスレッドで、考えたトークンが 4.6 の半分未満だったこと、1 回が $4.78 で 4.6 の $4.34 より少し高かったこと、Harvey が 19.6% で 5 位だったこと、を書いています。この 19.6% は xAI の表と同じ点です。
2026-09-22 の投稿は、xAI が SDK を直したあとに 10 位になった、と書いています。今の 60.20% と、Harvey の 12.08% は、そのあとの表です。
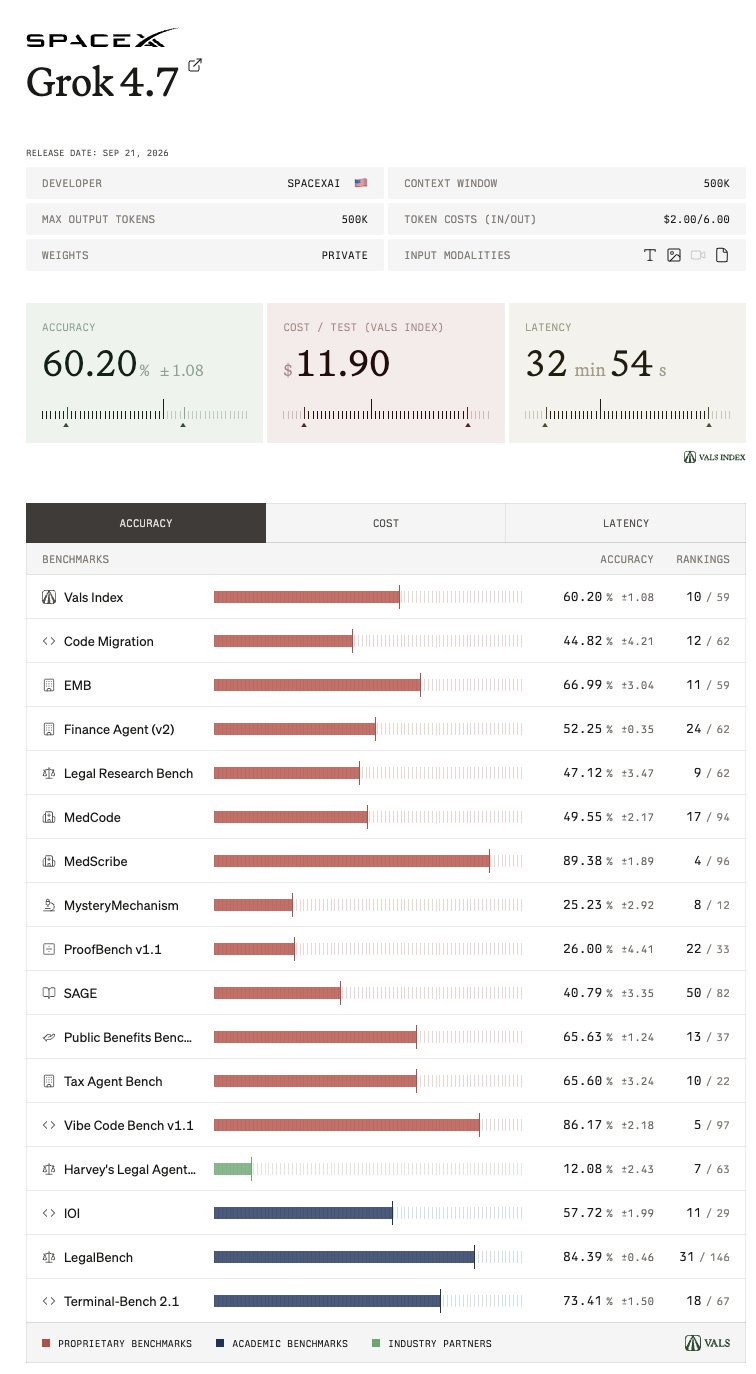
診療記録の MedScribe と、アプリを組む Vibe Code が強いです。証明の ProofBench と、教育の SAGE は弱いです。LegalBench は 84.39% でも 146 中 31 位で、点の高さはそのまま順位になりません。表の Harvey 12.08% は、出荷直後の 19.6% から動いたあとの点です。Terminal-Bench 2.1 の 73.41% は、xAI の Terminal-Bench 4.0 の 37.6% とは版が違います。
長い仕事は高くなります。コードの移植は 1 回 $36.55、Vibe Code は $15.83、IOI は $12.71、Harvey は $11.01 です。単価が安くても、課題が長いと 1 回に払う額は上がります。
イーロンの投稿
投稿の日付は UTC です。9/21 16:25 UTC は、日本時間の 9/22 1:25 です。x.ai が書いた発表日は 2026-09-21 です。
- 「4.6 は 2 週間、4.7 は 4 週間」。投稿
- 4.6 は 1.5 兆で 8/7 ごろ、4.7 は 2.1 兆でその数週間後に出る、と書いています。すべての面で 4.6 より良く、配る速さだけ少し遅く、トークン効率はさらに良い、とも書いています。投稿
- 4.6 よりかなり良く、3〜4 週間で出る。SpaceX の社内データを追加で学習している。投稿
- 今のモデル全部を、賢さで超える可能性が高い。投稿
- 10 日で出る。投稿
- あと数日。難しい問題を、できるのに早く投げ出す。見直しが足りない。投稿
- Opus 5.0 相当で、5.1 ではない。得意不得意がある。マルチモーダルは直す必要がある。4.8 ははっきり良くなる。4.9 が Astra と Fable の級かもしれない。投稿
- 賢さ、速さ、安さの組み合わせ。エージェントのコーディングでは Anthropic と OpenAI の次。毎日の仕事に回すなら良い。一番良い結果は Build と一緒に。賢さと安さ、3 番という投稿、Build
Grok 4.7 should be roughly on par with Opus 5.0, not 5.1. Better in some ways, worse in others. We need to fix multimodal performance. Grok 4.9 is probably Astra/Fable class.
2026-09-14 の投稿です。出荷した docs の入出力は、テキストと画像を入れて、テキストが出ます。Imagine は別のモデルのままです。
it still gives up on hard tasks (that it can do!) too early and isn’t yet sufficiently rigorous in checking its work.
2026-09-11 の投稿です。9/21 の発表が「長く働き、自分の出力を見直す」と書いたのは、この不満のあとです。
Grok 4.7 places @SpaceXAI as third, after Anthropic & OpenAI, for agentic coding. When factoring in that Grok is significantly faster & lower cost, it’s a great choice for your everyday workhorse.
2026-09-21 の投稿です。イーロンが書いたのは、Anthropic と OpenAI の次、という順位です。Artificial Analysis が書いた 4 番目は、Fable 5.1、Astra、Opus 5 の次です。
2.1 兆は、2026-07-28 の投稿の数字です。2026-09-21 に docs で確かめた仕様は、文脈 50 万トークン、入力 $2、出力 $6 です。7/28 は「トークン効率はさらに良い」とも書いています。9/21 の測り方では、総合点の 1 問の出力が増えています。社内データの話は 8/12 の投稿にあります。9/21 の発表が説明したのは、モデルを大きくしたこと、学習を長くしたこと、Grok Bot の進め方を覚えたことです。
9/14 の見通しは、総合点では近い結果です。4.7 は Opus 5 の 51 より下の 46 です。GDPval では Opus 5 の 1,708 のすぐ下で、Astra の 1,542 より上です。得意不得意がある、という文に近い並びです。8/15 の「全部を超える」は、この総合点では起きていません。
日本で使うなら
長いコードを Grok Build に書かせるなら、docs では 4.7 が既定です。イーロンも、Build と一緒に使うと一番良い、と書いています。単価は 4.6 と同じで、Fable の表の単価より安いです。ただし xhigh で長く考えると、1 問の出力は約 81,000 トークンまで増えます。安いのは 1 トークンの値段です。1 件で払う額は、書いた量で増えます。
プロンプトが 20 万トークンを超えると、単価が倍です。長いログを全部貼る前に、要る部分だけにします。知識の区切りは 2026 年 5 月です。それより新しいことは、API なら web search を付けるか、自分で資料を貼ります。
日本語の試験は、この発表の点数とは別です。英語で返ってきたら、今まで通り 会話の最初に 3 行貼ります。動画を作れる本数は、Imagine の決まりのままです。
Harvey と HealthBench はテストの点です。契約書や診断の判断には使いません。
よくある取り違え
- 「4.7 は全部のモデルに勝った」: 2026-08-15 の見通しです。2026-09-21 の総合は 46 で、Fable と Astra の 53、Opus 5 の 51 の下です
- 「チャットも今日から 4.7」: 案内されたのは Cursor、Grok Build、API です。grok.com は、開いている画面のモデル名を見てください
- 「Terminal-Bench は 38%」: xAI の表の 4.0 は 37.6% です。38% は四捨五入です。Artificial Analysis が Grok Build で測った 4.0 は 33%、Vals の 2.1 は 73.41% です
- 「Harvey は 19.6%」: 出荷直後は、xAI の表も Vals の投稿もその点でした。SDK を直したあとの Vals の掲載は 12.08% です
- 「Vals では 4.6 より下がった」: 出荷直後は 54.2% で 24 位、4.6 の 59.2% より下でした。SDK を直したあとの掲載は 60.20% で 10 位、4.6 の 59.17% の上です
- 「単価が同じなら請求も同じ」: 単価は同じです。総合点の 1 問で出力が約 81,000 トークンになり、4.6 の high の約 36,000 より多いです
- 「2.1 兆が仕様」: 2026-07-28 の投稿の数字です。出荷日に docs で確かめた仕様は、文脈 50 万、入力 $2、出力 $6 です
コメント
いまはコメントを受け付けていません。記事はそのまま読めます。